この度、弊社ではMujoを活用したJRAの競馬予想サイトをオープンしました。
現在、2015年以降のJRAの全レースのレース結果が格納されているMujoのDockerコンテナを稼働させており、毎週末にレースが行われる度にコンテナを作成しなおして、日々データを蓄積しています。
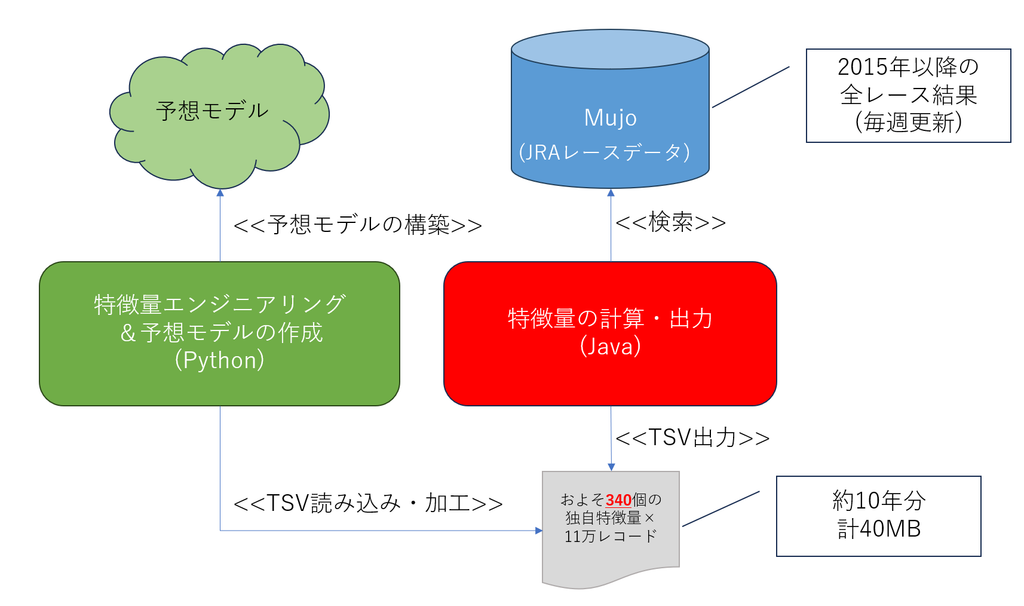
Mujoには2015年以降の競馬場、レース毎の出走馬、着順、走破時計、馬場状態などなど、基本的なレース結果が格納されており、これを元に完全独自の特徴量を出力して、以下の図のとおり、予想モデルを構築しています。
特徴量は現時点で340個(カラム)ほどあり、筆者が毎週2つ3つ思い浮かんでは増えていっており、TSVも肥大化の一途をたどっています。モデルにフィットせず、不要な特徴量も一定数ありますが、いずれ本当に不要かどうかを見極めて整理したいと考えています。
現在は通称「モデルf」と呼ばれている3歳以上、2勝クラス以上のレースの単勝1番人気以外の複勝をメインに予想するモデル構築して、累計回収率が100%を超える買い目も存在しています。(2026年11月末現在)
これまで公開している予想と、その予想に対する成否は、以下の画像をクリックするとスプレッド形式でご覧になれます。
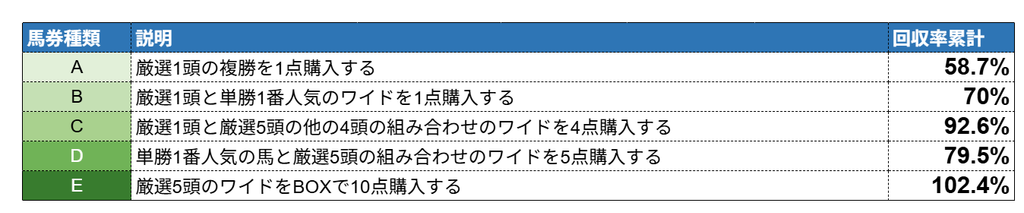
「モデルf」は、レースに出走する中で複勝圏内に来そうな上位5頭を「厳選5頭」とし、とその中で最も複勝圏内に来そうな馬を「厳選1頭」という形で予想しています。
過去、「厳選1頭」の複勝(上の画像のAの買い目)を購入しつづけた際の、JRA即パッドのスクリーンショットです。
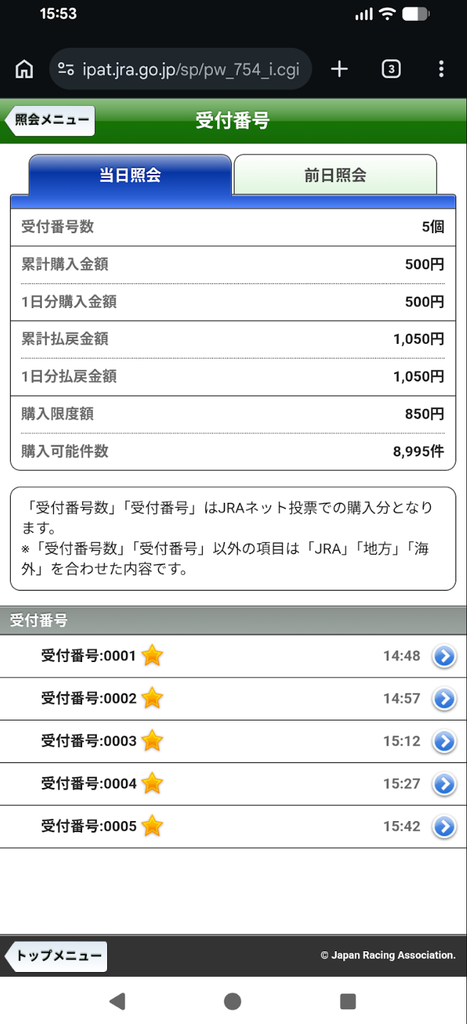
画像は一切加工してありません。当日の各レースの出走頭数から計算すると、5レース連続で的中させるのは、0.0009%の確率でした。(1000回に1回もない出来事)
この週のあと、予想サイトをオープンし、「モデルf」の予想を公開し始めましたが、「厳選1頭」の方の的中率、回収率はあまり芳しくなく、毎週モデルを更新しては、オーバーフィッティングしていないかを確認し、なるべく再現性のありそうなモデルで毎週末を迎えようと日々奮闘しています。
さて、レース当日ですが、以下のような構成で予想を出力しています。
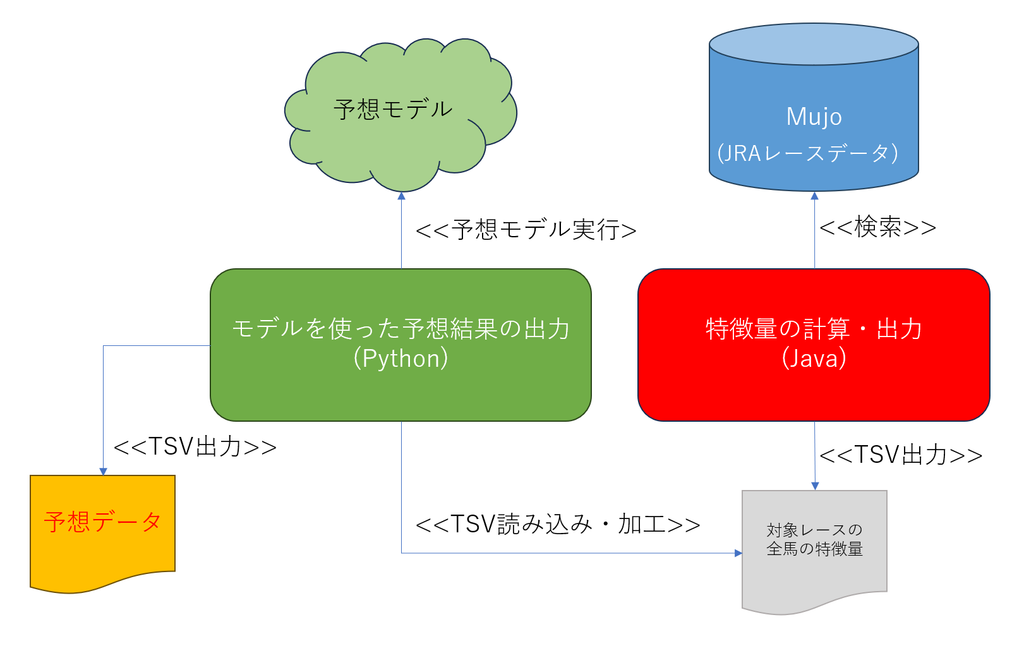
予想はレースのおよそ5分前に発表していますので、レースに出走する馬のその時点での成績を元にした特徴量を素早く出力できなくては、馬券が買えず予想の意味を持ちません。
例えば、2026年の天皇賞(秋)であれば、勝ったダノンデサイルや2着になったネブラディスクなど、出走馬すべてのレース当日までの成績を元にした特徴量を素早く出力できる必要があります。(さらに、そのあとの工程では、出力したTSVを特徴量としてPythonを起動して、モデルを実行しなくてなりませんから、モタモタしている暇はないのです)
Mujoの検索性能は、QuarkusのMicrometer形式でメトリクスを配信しています。
前述した約10年分の出走馬の特徴量を出力する際に取得したメトリクスですが、これをGrafanaで可視化しました。
特徴量のTSVを出力するバッチプログラムはおよそ30分くらい動いています。
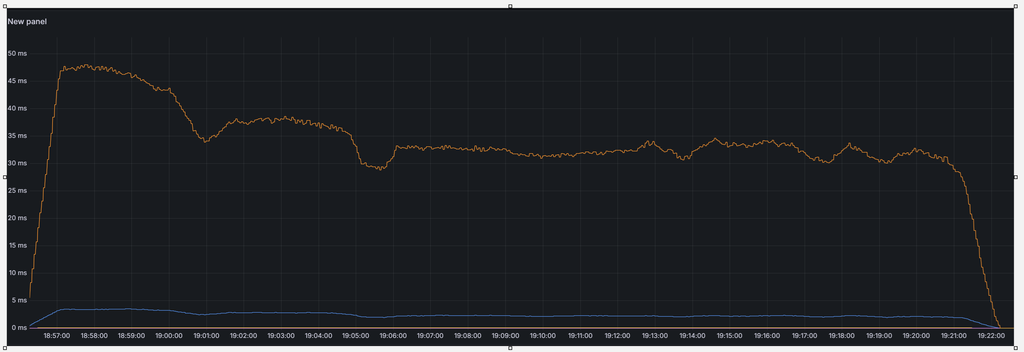
オレンジの線が出走馬ごとに過去成績を馬名をキーに検索する処理、下の青い線がレースのキー情報から、レースに出走した馬や着順、走破時計などを検索する処理のそれぞれの検索に掛かった時間を示しています。(単位はmilliseconds)
実装上は完全なN+1クエリーで、レース情報の検索が1回、そのレースに出走した全頭の過去成績がN回検索されます。(Ex.レースが18頭立ての場合は、1レース分の特徴量を出力するのに、少なくとも19回の検索が実行されます)
MujoはローカルPCのDockerコンテナで起動しており、TSVを出力するJavaのバッチプログラムは1年単位に別スレッドで同一のロジックを実行し、5スレッドで動かしています。どの検索処理も50msに収まっており、ある程度の負荷でも安定した検索性能が出せることがわかります。
ところで、当然と言えば当然なのですが、理論上はプログラムの構成図を以下のように変更することも可能です。(厳密にはコンテナを差し替えるだけです)
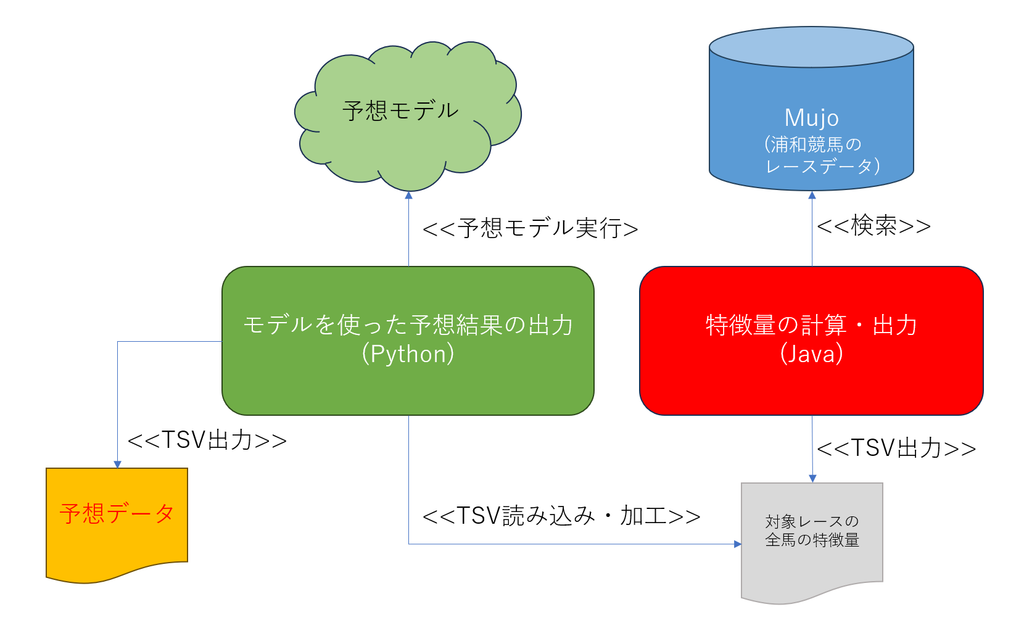
ある程度のカスタマイズは必要かもしれませんが、データさえ用意できれば、コンテナを差し替えるだけで浦和競馬など、地方競馬にも対応可能です。
現在は、半手動で予想、その公開、結果の更新を行う必要はありますが、モデルの最新データによる学習や定刻になったら自動で予想して、予想内容を投稿するなど、いずれは全自動化できれば良いなと思っています。
それでは!